Series是Pandas库中最简单也最常用的一个数据结构,非常类似C/C++中的一维数组、Python中的一维列表。本质就是一个可以有索引(下标)和值的一维数组,只不过是竖着排列的,样子就像Excel中的一列。
下面给大家举个简单例子来看看,比如我们有一组数字,5个,放到Series里,可以这么写代码:
import pandas as pd
a=[1,5,7,3,8]

s=pd.Series(a)

print(s)
只有四行,第一行是引入pandas库,第二行是定义了一个list列表,然后第三行是pandas库中Series函数的调用,同时把数据传入。然后返回值s就可以打印了,其运行效果如下:
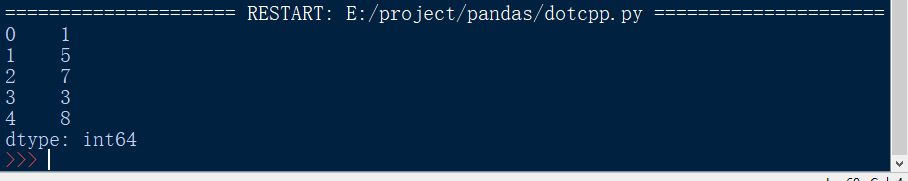
大家可以看到打印是竖着的,也就是一列,只不过除了右侧我们的数字之外,左侧还有对应的索引,默认是0~4 五个分别对应五个数字,这就是Series序列的最简单用法!
进一步的,我们如果不想用默认的0开始递增的索引,想改变其他数值的索引,甚至是字母,都是可以的,比如我们想改成11、12、13、14、15五个索引。顺手为此Series增加一个名字,则可以这么写:
import pandas as pd
a=[1,5,7,3,8]
a_index=[11,12,13,14,15]  #新建的索引值
s=pd.Series(a,a_index,name='dotcpp') #指定Series名称为dotcpp

print(s)
大家可以自行阅读代码,并参考注释。结合运行效果如下:
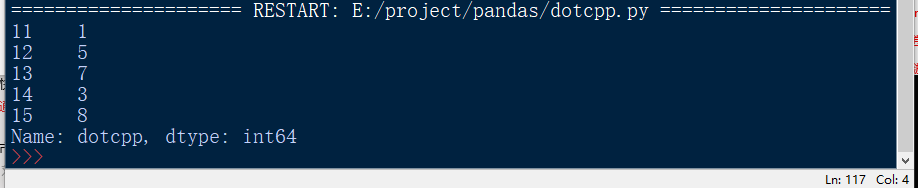
索引的作用,可以允许我们通过索引值去找对应的内容,比如想输出8这个值,那我们可以通过索引值15去输出,代码如下:
import pandas as pd
a=[1,5,7,3,8]
a_index=[11,12,13,14,15]
s=pd.Series(a,a_index,name='dotcpp')

print(s[15])
大家可以上机调试更改其中的数值来加深对Series函数的理解,完成之后可以学习Series函数的原型,以更全面的认识Series函数,原型如下:
pandas.Series(data=None, index=None, dtype=None, name=None, copy=False, fastpath=False)
各个参数意义如下:
| data | Series 的数据部分,可以是列表、数组、字典、标量值等。如果不提供此参数,则创建一个空的 Series。 |
| index | Series 的索引部分,用于对数据进行标记。可以是列表、数组、索引对象等。如果不提供此参数,则创建一个默认的整数索引。 |
| dtype | 指定 Series 的数据类型。可以是 NumPy 的数据类型,例如 np.int64、np.float64 等。如果不提供此参数,则根据数据自动推断数据类型。 |
| name | Series 的名称,用于标识 Series 对象。如果提供了此参数,则创建的 Series 对象将具有指定的名称。 |
| copy | 是否复制数据。默认为 False,表示不复制数据。如果设置为 True,则复制输入的数据。 |
| fastpath | 是否启用快速路径。默认为 False。启用快速路径可能会在某些情况下提高性能。 |
大家这样就可以对应每个参数的作用,并能看到Series函数的全貌了!
C语言网提供由在职研发工程师或ACM蓝桥杯竞赛优秀选手录制的视频教程,并配有习题和答疑,点击了解:
一点编程也不会写的:零基础C语言学练课程
解决困扰你多年的C语言疑难杂症特性的C语言进阶课程
从零到写出一个爬虫的Python编程课程
只会语法写不出代码?手把手带你写100个编程真题的编程百练课程
信息学奥赛或C++选手的 必学C++课程
蓝桥杯ACM、信息学奥赛的必学课程:算法竞赛课入门课程
手把手讲解近五年真题的蓝桥杯辅导课程