要么说Python擅长做数据分析呢,Pandas库中给我们带了corr函数,这个函数可以帮助我们对数值类数据进行相关性分析,比如对比某两列数据的变化是否有正相关?或负相关,即一个数值递增都使另一个数也增加,这就是正相关,反之则是负相关,corr函数用 -1~1 之间的一个浮点数表示这个程度。
我们来个例子,还是我们前面的天气数据,比如我们想利用corr函数帮我们分析最高温度和平均温度这两列的关系,我们可以写这样一段代码:
import pandas as pd

df=pd.read_csv('weather.csv')

c=df[['temp_max','humidity']].corr()

print(c)
大家可以阅读代码,其中第三行我们调用了corr函数,默认没有传递任何参数。注意前面的df变量到是传入了两个字符串,原因是我们的weather数据中有字符这类corr无法处理的数据,只能指定纯数字的列才可以分析。然后打印输出即可看到效果:
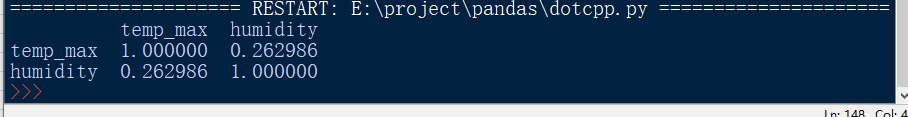
这就是corr函数的效果,他默认会2x2的信息返回,注意对角线上都是1.000000因为是数值自身,所以是100%正相关,而其余两个值是表示这两个数有相关性,但并不那么明显,即不强的相关性。
如果我们想增加最低温度,一共三组比较数据的相关性情况,我们可以写:
import pandas as pd

df=pd.read_csv('weather.csv')

c=df[['temp_max','temp_min','humidity']].corr()

print(c)
效果如下:
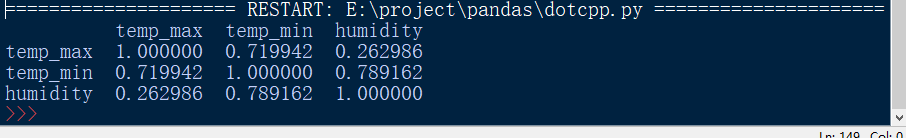
可以看到,temp_min和temp_max成较高的相关性(0.7+)意味“是否最高温度高的地方最低温度也高”等假设可供我们详细分析。
这就个简单的例子,就是用corr函数,使用默认的pearson'(皮尔逊)算法进行的两组数据的相关性,而更多的算法系数一共三种,都可以使用,分别是:
'pearson'(皮尔逊)、'spearman'(斯皮尔曼)、'kendall'(肯德尔)。
具体选择上,皮尔逊相关系数适用于衡量线性关系(即前面提到和演示的例子),而斯皮尔曼和肯德尔相关系数适用于衡量单调关系,大家可以详细了解算法根据需要选择
实际工作当中,corr函数常常用于各行各业数据分析、关联判断、假设验证等等,非常实用。建议大家熟悉语法后可以再详细了解
C语言网提供由在职研发工程师或ACM蓝桥杯竞赛优秀选手录制的视频教程,并配有习题和答疑,点击了解:
一点编程也不会写的:零基础C语言学练课程
解决困扰你多年的C语言疑难杂症特性的C语言进阶课程
从零到写出一个爬虫的Python编程课程
只会语法写不出代码?手把手带你写100个编程真题的编程百练课程
信息学奥赛或C++选手的 必学C++课程
蓝桥杯ACM、信息学奥赛的必学课程:算法竞赛课入门课程
手把手讲解近五年真题的蓝桥杯辅导课程